Das passende Training Kubernetes Monitoring Training – Praxisnah & Hands-on
Prometheus reicht - bis euer Cluster wächst. Dann kippt es leise
Ganz ehrlich: Prometheus ist in fast jedem Kubernetes-Monitoring-Training das Standard-Setup, und das zu Recht. Nur erlebe ich immer wieder Teams, die überrascht sind, wenn genau dieses Standard-Setup bei wachsendem Cluster plötzlich zäh wird. Nicht kaputt - nur langsam, teuer (mehr RAM, größere VMs), und irgendwann unzuverlässig.
Das Problem heißt Kardinalität, nicht Auslastung
Der Grund ist selten “zu viele Metriken”. Der Grund ist Kardinalität - und die ist simpler, als der Fachbegriff klingt. Wörtlich heißt Kardinalität einfach nur “Anzahl”: wie viele unterschiedliche Werte in einem Topf stecken. Auf Prometheus übertragen: wie viele unterschiedliche Zeitreihen durch die Label-Kombinationen entstehen. Jedes Label an einer Metrik multipliziert sich mit jedem anderen Label zu einer eigenen Zeitreihe.
Warum multipliziert sich das eigentlich, statt sich zu addieren? Ganz einfach: Eine Zeitreihe ist nie “der Pod” oder “der Statuscode” für sich allein. Es ist immer die ganze Kombination. Jede Anfrage hat gleichzeitig einen Pod, einen Statuscode und einen Endpoint - und genau diese eine Kombination bekommt ihre eigene Zeitreihe. Kommt ein weiteres Label dazu, addiert sich nichts dazu. Es wird mit jeder bisherigen Kombination neu verknüpft. Genau das ist der Multiplikator.
Ein Beispiel macht das greifbar. Eine einzige Metrik wie http_requests_total, aufgeschlüsselt nach Pod (50 Stück), Statuscode (10 mögliche) und Endpoint (20 Routen): 50 × 10 × 20 = 10.000 Zeitreihen - für eine einzige Metrik. Kommt jetzt noch, weil’s “praktisch fürs Debugging” ist, eine User-ID als Label dazu (bei 10.000 Nutzern), multipliziert sich das nochmal drauf: 10.000 × 10.000 = 100 Millionen Zeitreihen, aus einer einzigen Metrik. Kein Extrembeispiel - genau in dieser Größenordnung stößt Uber laut eigenen Angaben bei einzelnen Metrik-Emissionen an die Grenzen von Prometheus.
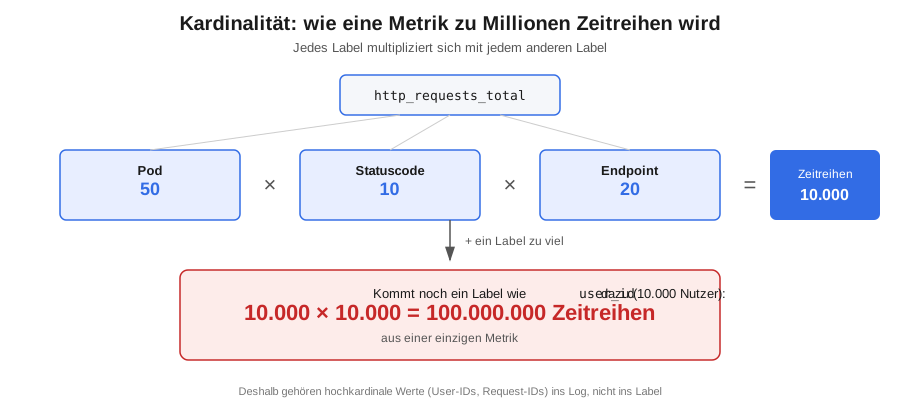
In Kubernetes ist das ein eingebautes Risiko: Pod-Namen wechseln bei jedem Rollout, Namespaces vermehren sich. Und wer aus Versehen eine Request-ID als Label einträgt statt als Log-Feld - Uupsi! - hat richtig Pech. Jede Anfrage bringt eine neue Request-ID mit. Also entsteht bei jeder einzelnen Anfrage eine komplett neue Zeitreihe, die nie wieder auftaucht. Kein endliches Produkt mehr wie bei der User-ID. Einfach unbegrenztes Wachstum. Ein Setup, das bei 100 Nodes stabil läuft, kann bei 300 Nodes mit exakt derselben Label-Strategie kollabieren - RAM-Verbrauch springt von einstelligen auf zweistellige GB-Werte, Queries werden zäh. Und mehr RAM heißt in der Cloud nicht “kostet halt ein bisschen mehr” - es heißt größere, teurere VMs für eine Komponente, die eigentlich nur beobachten soll, nicht mitverdienen.
Warum das so oft übersehen wird
Weil es nicht crasht. Es wird schleichend langsamer, die Grafana-Dashboards laden zäher, Alerts kommen verzögert - und alle schieben es erstmal auf “der Cluster ist halt gewachsen, ist normal”. Ist es aber nicht. Ein einzelner Prometheus-Knoten wird als Faustregel ab grob 10 Millionen aktiven Zeitreihen unzuverlässig - und dieser Punkt kommt in wachsenden Clustern schneller, als die meisten planen.
Meine klare Ansage
Erste Reaktion bei Performance-Problemen ist fast immer “mehr RAM”. Kurzfristig hilft das. Es löst aber nichts, es verschiebt nur den Zeitpunkt, an dem ihr wieder vor demselben Problem steht.
Der eigentliche Fix ist zweigleisig: Label-Strategie bewusst gestalten (hochkardinale Werte gehören ins Log, nicht ins Label), und für Langzeit-Speicherung und Multi-Cluster-Sicht auf ein System wie Thanos setzen statt alles im lokalen Prometheus zu bunkern.
Fazit
Prometheus ist nicht das falsche Tool. Es ist das Tool, dessen Grenzen die wenigsten kennen, bevor sie dagegenlaufen - und genau deshalb gehört Kardinalität für mich in jedes Monitoring-Training, nicht nur “wie installiere ich Prometheus und Grafana”.
Mein Kubernetes-Monitoring-Training behandelt genau diesen Übergang - vom Standard-Setup zum Setup, das auch bei wachsendem Cluster noch trägt, bevor ihr an dem Punkt seid, an dem es schon wehtut.